
Українська
Межі, зміни та розбір алгоритмів
Межі, зміни та перевірка стану
Вектор є безпечним власником пам’яті, але не виправляє помилковий алгоритм індексації. У Debug бібліотека може виявити доступ за межі, однак Release не зобов’язана повторити те саме повідомлення. У лабораторній використовуйте перевірку меж до доступу; навмисне порушення запускайте лише як окремий діагностичний дослід, не як робоче рішення.
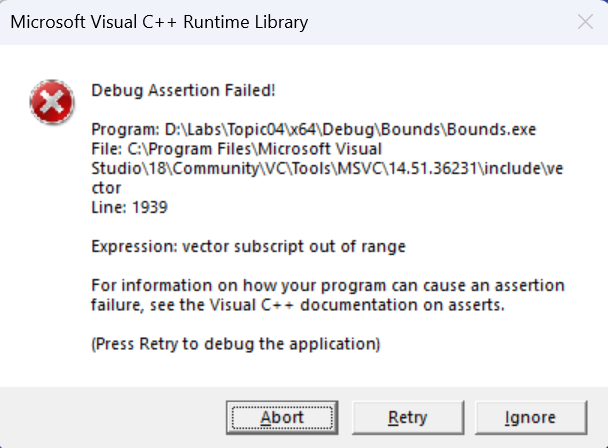
Рис. 4.6. Діагностика неправильного індексу в Debug
При вилученні елементів під час індексного обходу наступний елемент пересувається на поточне місце. Якщо відразу збільшити індекс, він буде пропущений. Варіанти: не збільшувати індекс після вилучення, обходити з кінця або сформувати окремий вектор з елементів, які потрібно залишити. Для початківця третій спосіб часто найпрозоріший.
Запис const auto& first = values[0] і наступний push_back можуть створити висяче посилання при зміні буфера. Якщо потрібне саме значення, збережіть копію. Якщо потрібно знайти елемент після структурних змін, застосуйте сталий ключ запису й повторний пошук. Навіть індекс може стати неправильним після вставлення перед відповідним елементом.
Незалежні перевірки
Для пошуку підготуйте порожню колекцію, один елемент, збіг на початку, всередині, в кінці та відсутній ключ. Для сортування перевірте, що порядок правильний і що початкові елементи не загубилися й не з’явилися зайві. Дублікати особливо корисні для перевірки цієї властивості.
Для рядкового алгоритму важливі порожній рядок, самі розділювачі, один токен і кілька поспіль розділювачів. Явно визначте, чи порожні поля рахуються. Розбиття «слів за пробілами» і розбір CSV є різними задачами: у CSV лапки можуть дозволяти розділювач усередині поля. Не називайте простий split повноцінним CSV-парсером.
У матрицях використовуйте також 1×N і N×1. Якщо алгоритм бере сусідів клітинки, кути й краї мають менше сусідів. Перевірка кожної координати має передувати індексації, а не слідувати за нею. Ці тести перевіряють структуру даних, а не лише один очікуваний текст консолі.
Розбір алгоритмів на малих даних
Зрозуміти індексний алгоритм легше на короткій послідовності, для якої можна виписати кожний стан. Візьмімо значення 7,2,5,2. При сортуванні вибором на першому кроці найменше значення 2 знайдено на позиції 1. Після обміну з позицією 0 отримаємо 2,7,5,2. На другому кроці пошук починається з позиції 1 і знаходить 2 на позиції 3. Результат 2,2,5,7 уже впорядкований, але алгоритм все одно завершує заплановані кроки перевірки решти.
Таблиця 4.1. Інваріант сортування вибором
| Крок | Впорядкований початок | Ще не оброблена частина |
|---|---|---|
| 0 | порожній | 7, 2, 5, 2 |
| 1 | 2 | 7, 5, 2 |
| 2 | 2, 2 | 5, 7 |
| 3 | 2, 2, 5 | 7 |
| 4 | 2, 2, 5, 7 | порожня |
Ключове твердження: оброблений початок містить найменші елементи у правильному порядку. Внутрішній цикл не змінює дані, а лише запам’ятовує позицію найкращого кандидата. Один обмін виконується після завершення пошуку. Якщо обмінювати при кожному порівнянні, це буде інший алгоритм із іншими властивостями; його також можна написати правильно, але пояснення має відповідати реальному коду.
Стійкість сортування означає збереження взаємного порядку записів з однаковим ключем. Для простих чисел різницю не видно, а для студентів із однаковими балами вона важлива. Додайте до кожного числа ім’я: 7 А,2 Б,5 В,2 Г. Обмін може переставити рівні ключі щодо інших записів. Якщо умова вимагає алфавіт при однаковому балі, це вже додатковий ключ порівняння, який слід явно реалізувати й перевірити.
Бінарний пошук без пропущених меж
Нехай відсортована послідовність має значення 2,5,8,11,14,17. Початковий інтервал [0,6) містить усі шість позицій. Для пошуку 14 середина дорівнює 3, а значення 11 менше ключа. Тому ліва межа стає 4, і новий інтервал [4,6). Середина 5 містить 17, отже права межа стає 5. Залишається [4,5), де знайдено 14.
Якби шукали 13, останнє порівняння з 14 зменшило б праву межу до 4. Інтервал [4,4) порожній, тому результат «не знайдено». Умова продовження – left < right. Кожний крок або збільшує ліву межу, або зменшує праву, тому довжина інтервалу зменшується. Присвоєння left = middle замість middle + 1 може залишити той самий інтервал і створити нескінченний цикл.
При повторюваних ключах звичайний пошук повертає певний збіг, але не обов’язково перший. Якщо потрібні всі записи, визначте окрему задачу пошуку лівої та правої межі групи. Не продовжуйте читати сусідів, не перевіривши індекс: група може починатися на 0 або закінчуватися останнім елементом.
Вставлення та вилучення як зміна моделі
У списку покупок індекс 1 може позначати «чай». Після вставлення нового товару на початок чай матиме індекс 2. Якщо програма зберегла 1 як «ідентифікатор чаю», вона тепер змінить інший товар. Це проблема моделі даних, навіть якщо всі індекси формально залишилися в межах. Для стійкого посилання на запис додають окреме поле id.
Розгляньмо вилучення всіх від’ємних із вектора {-2,-3,4}. Після вилучення позиції 0 отримаємо {-3,4}. Якщо збільшити i до 1, число−3 не буде перевірене. Правильний індексний цикл залишає i незмінним після erase і збільшує лише тоді, коли поточний елемент збережено. Це зберігає інваріант «усі позиції перед i вже перевірені».
Інший підхід створює порожній результат і додає до нього лише невід’ємні значення. Його переваги – простий обхід і відсутність зсувів під час читання. Недолік – додаткова пам’ять. Для навчальних обсягів це часто добра ціна за ясність. Після завершення можна замінити початковий вектор результатом.
Не виконуйте структурне вилучення з того самого вектора всередині звичайного діапазонного for без розуміння правил чинності ітераторів. Прихований механізм обходу може бути зруйнований зміною. Можливість змінювати значення через auto& не означає можливість безпечно змінювати саму структуру колекції.