
Українська
Приклади програм і типові помилки
Приклади програм
Приклад 1. Матриця вимірювань
Три датчики зробили два вимірювання. Потрібно додати індивідуальні поправки, відхилити нечислові чи нескінченні дані та показати середнє кожного датчика. Функція не змінює передані масиви.
py
import numpy as np
from numpy.typing import NDArray


def calibrate(data: NDArray[np.float64],
              offsets: NDArray[np.float64]) -> NDArray[np.float64]:
    if data.ndim != 2 or data.shape[0] == 0:
        raise ValueError("Потрібна непорожня матриця")
    if data.shape[1] == 0 or offsets.shape != (data.shape[1],):
        raise ValueError("Поправка потрібна для кожного датчика")
    if not np.isfinite(data).all() or not np.isfinite(offsets).all():
        raise ValueError("Значення мають бути скінченними")
    return data + offsets


def main() -> None:
    data = np.array([[10., 20., 30.], [12., 22., 32.]])
    fixed = calibrate(data, np.array([1., -1., 2.]))
    for index, value in enumerate(fixed.mean(axis=0), start=1):
        print(f"Датчик {index}: {value:.1f}")
    print(f"Загальний максимум: {fixed.max():.1f}")


if __name__ == "__main__":
    main()
Результат:
Датчик 1: 12.0
Датчик 2: 20.0
Датчик 3: 33.0
Загальний максимум: 34.0
Перевірка shape відбувається до додавання, тому випадкова сумісність broadcasting не приховує неправильну кількість поправок. Масив результату незалежний, бо додавання створює нові дані. У тесті порівняйте оригінал до й після виклику, передайте одну поправку замість трьох, NaN і порожню матрицю.
Приклад 2. Очищення навчальних продажів
У CSV є категорія, кількість і ціна в копійках. Дозволено цілі кількості 1–1000, ціни 0–100000 та непорожню категорію. Помилкові записи показуємо окремо; підсумок рахуємо лише після валідації. Файл не містить багаторядкових текстових полів.
py
from io import StringIO
import pandas as pd


def main() -> None:
    source = ("category,qty,price\n"
              "paper,2,2500\npen,3,1000\npaper,bad,1200\n")
    frame = pd.read_csv(StringIO(source), dtype="string")
    qty = pd.to_numeric(frame["qty"], errors="coerce")
    price = pd.to_numeric(frame["price"], errors="coerce")
    valid = (qty.between(1, 1000) & price.between(0, 100000)
             & qty.mod(1).eq(0) & price.mod(1).eq(0)
             & frame["category"].str.strip().ne(""))
    valid = valid.fillna(False)
    clean = frame.loc[valid].copy()
    clean["total"] = (qty[valid] * price[valid]).astype("int64")
    clean["category"] = clean["category"].str.strip()
    report = clean.groupby("category")["total"].sum()
    for category, cents in report.items():
        print(f"{category}: {cents // 100},{cents % 100:02d}")
    print(f"Відхилено: {int((~valid).sum())}")


if __name__ == "__main__":
    main()
Результат: paper: 50,00, pen: 30,00, Відхилено: 1. Межі одночасно відкидають нескінченності. Пропущені результати маски явно перетворені на False; вони не повинні зникнути зі звіту відхилення. У цьому короткому прикладі виводимо кількість помилок; у лабораторних варіантах потрібно також повернути номери й причини. Грошовий підсумок зберігає копійки.
Приклад 3. Енергія за днями
Кожний запис містить енергію за окремий інтервал, а не накопичений показник. Потрібно перевірити час, відсортувати записи й додати інтервали кожного дня. Пропущений день позначаємо як відсутність даних; не підміняємо його нульовим споживанням.
py
import pandas as pd


def main() -> None:
    frame = pd.DataFrame({
        "time": ["2026-09-01 08:00", "2026-09-01 09:00",
                 "2026-09-03 08:00"],
        "kwh": [1.5, 2.0, 1.0]})
    frame["time"] = pd.to_datetime(
        frame["time"], format="%Y-%m-%d %H:%M", errors="raise")
    if frame["time"].duplicated().any():
        raise ValueError("Повторний інтервал")
    series = frame.set_index("time").sort_index()["kwh"]
    daily = series.resample("D").sum(min_count=1)
    for day, value in daily.items():
        shown = "немає даних" if pd.isna(value) else f"{value:.1f}"
        print(f"{day:%d.%m}: {shown}")


if __name__ == "__main__":
    main()
Результат: 01.09: 3.5, 02.09: немає даних, 03.09: 1.0. min_count=1 вимагає хоча б одного значення, інакше результат пропущений. Перевірте випадок дублювання часу й порожній набір. Для реального журналу додайте перевірку невід’ємності та скінченності енергії перед побудовою часової серії.
Приклад 4. Звіт із двох графіків
Побудувати зміну двох датчиків у часі та стовпці їхніх середніх. Усі значення тут задані в програмі. Лінії різняться маркерами й типом штриха, тому залишаються зрозумілими в монохромному друці.
py
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt


def main() -> None:
    hours = np.array([8, 10, 12, 14])
    data = np.array([[18., 19.], [20., 21.],
                     [22., 23.], [21., 22.]])
    fig, axes = plt.subplots(1, 2, figsize=(8, 3.2),
                             layout="constrained")
    for index, style in enumerate(["o-", "s--"]):
        axes[0].plot(hours, data[:, index], style,
                     color="black", label=f"Датчик {index + 1}")
    axes[0].set(xlabel="Година", ylabel="Температура, °C")
    axes[0].legend()
    axes[0].grid(alpha=0.3)
    axes[1].bar(["1", "2"], data.mean(axis=0),
                color="0.8", edgecolor="black", hatch="//")
    axes[1].set(xlabel="Датчик", ylabel="Середня, °C", ylim=(0, 25))
    fig.savefig("sensor-report.png", dpi=200)
    plt.close(fig)
    print("Збережено sensor-report.png")


if __name__ == "__main__":
    main()
Результат – файл sensor-report.png та повідомлення про його збереження. Для першого датчика середнє 20,25 °C, для другого – 21,25 °C. На рис. 13.6 видно і динаміку, і порівняння середніх; одна стовпчикова діаграма приховала б зміну протягом дня.
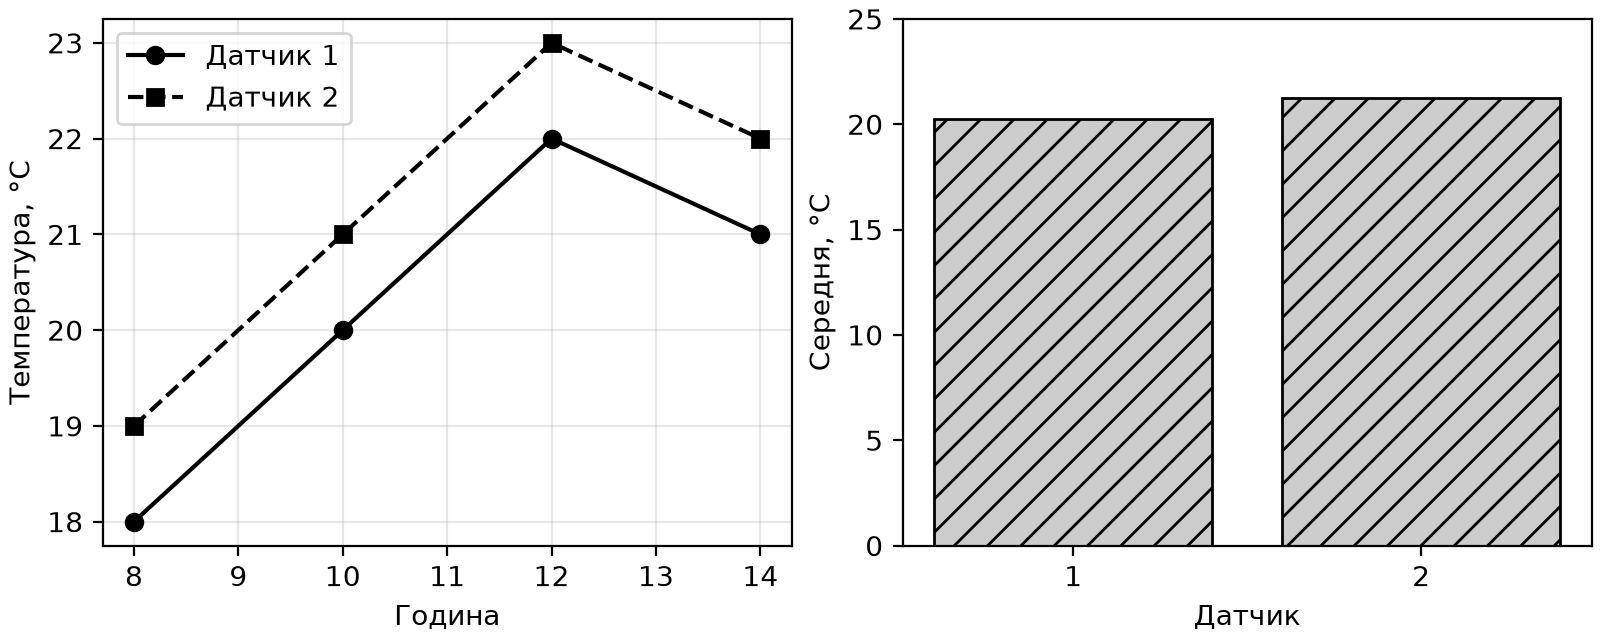
Рис. 13.6. Зміна температури та середні значення датчиків
Знімок екрана
Open sensor-report.png; show readable axes and legend.
Рис. 13.7. Перегляд збереженого графіка у PyCharm
Перевірка конвеєра й типові помилки
Тестуйте обчислювальні функції окремо від файлового введення та побудови зображення. Для NumPy є np.testing.assert_allclose, для pandas – pd.testing.assert_frame_equal. Укажіть допустиму похибку там, де вона має фізичний зміст. Виведення з різним форматуванням таблиці не обов’язково означає різні дані.
Корисний набір перевірок: порожній вхід, один запис, пропуск, нечислове значення, нескінченність, дубль ключа, неправильна форма, несподівана категорія, відсутній довідник. Для кожної обробки з відкиданням має виконуватися баланс: кількість прочитаних записів дорівнює кількості прийнятих і відхилених. Для групування перевірте суму до й після, для merge – кількість рядків і кратність ключів.
Перевірка PNG складається з двох частин. Автоматично можна переконатися, що файл створено й має розміри; очима – що не обрізано підписи, одиниці правильні та легенда відповідає серіям. Наявність зображення ще не доводить коректність даних. У звіті лабораторної роботи наведіть невеликий ручний розрахунок для одного підсумку та поясніть політику пропусків.
Таблиця 13.1. Типові помилки числового та табличного аналізу
| Помилка | Причина та виправлення |
|---|---|
| Неправильні середні | Переплутано axis; перевірте форму результату. |
| Змінився оригінал NumPy | Зріз є поданням; для незалежності потрібна copy. |
| Присвоєння pandas не спрацювало | Замість ланцюжка використайте одну .loc. |
| Кількість рядків після merge зросла | Перевірте кратність ключів через validate. |
| Пропуски стали нулями | Політика заповнення змінила зміст; поясніть її. |
| Графік не завершує програму | Для пакетного запуску використайте Agg і savefig. |